Super-agent DeepSeek: projekt agenta, który pracuje w tle
1 listopada zespół DeepSeek Harness opisał architekturę, którą nazywa Super-agentem: jednego agenta, który jest stale online, słucha czatu i GitHuba i prowadzi kilka zadań naraz. Dzień wcześniej na koncie deepseek-ai pojawił się prototyp na licencji MIT. Autorzy zastrzegają, że tekst przedstawia pomysły na architekturę, a nie gotowe funkcje DeepSeek Harness, i że prototyp nie jest oficjalnym produktem. Poniżej pięć koncepcji, które warto znać, zanim wpuści się agenta do firmowego czatu, i wskazówki, co z nich przenieść.
Wąskie gardło: ludzka uwaga
Pojedyncze zadanie agent programistyczny wykonuje dziś przy coraz mniejszym nadzorze. Kłopot zaczyna się przy kilku zadaniach naraz: każda sesja ma osobny kontekst, a człowiek przełącza się między nimi i pamięta, co jest w której. Zespół DeepSeek Harness ocenia z własnego doświadczenia, że da się tak śledzić od trzech do pięciu aktywnych sesji.
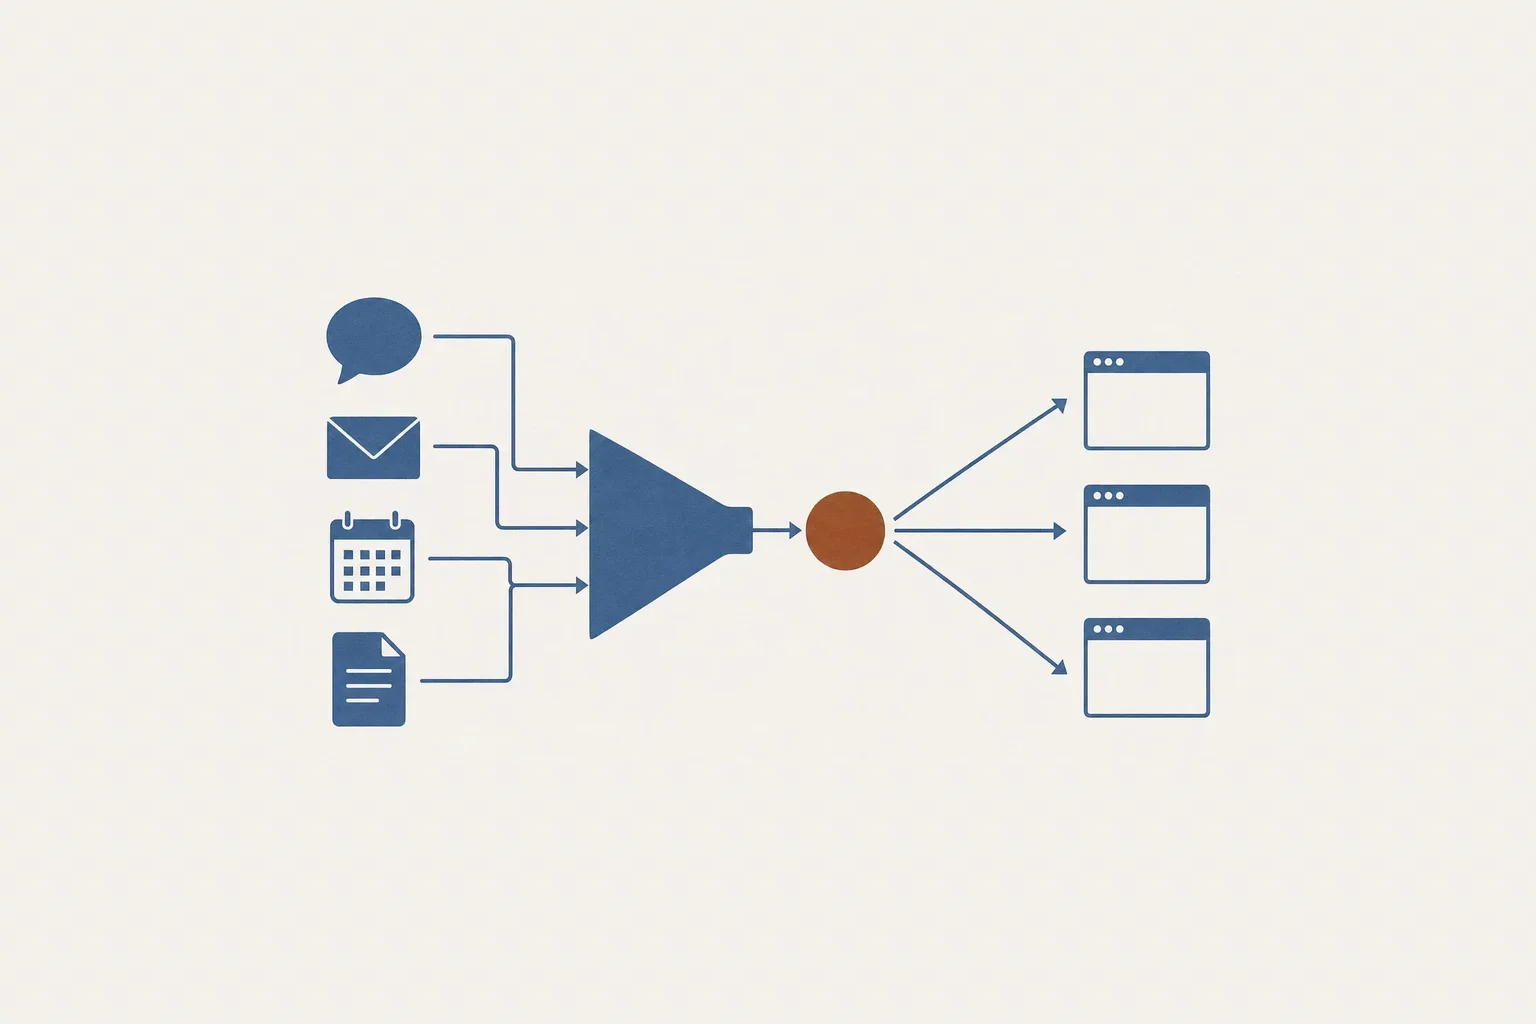
Odpowiedzią ma być Super-agent: jeden agent z ciągłą pamięcią rozmów na wszystkich kanałach, który sam reaguje na zdarzenia, pracuje nad kilkoma zadaniami równolegle i nie wyłącza się razem z laptopem. Wewnętrzna instancja Super-agenta w DeepSeek czyta zgłoszenia na grupowym czacie i otwiera pull requesty z poprawkami, nawet gdy nikt jej nie oznaczył.
Router przydziela, wykonawcy pracują
Architektura ma dwie warstwy. Router to jedna długo działająca sesja, która rozmawia z ludźmi, zna stan wszystkich zadań i przydziela je dalej. Sam pracy nie wykonuje, więc według autorów zwykle wystarcza mu lżejszy, szybszy model. Każdy wykonawca (Worker) dostaje jedno zadanie, własny kontekst i pełny zestaw narzędzi, a z ludźmi komunikuje się wyłącznie przez router. To od wykonawców zależy jakość kodu, więc zwykle potrzebują najmocniejszego modelu.
Dlaczego nie wystarczy jedna sesja, która uruchamia subagentów? W eksperymencie autorów model z neutralnym promptem („użyj subagenta, gdy to stosowne”) w żadnym z pięciu przebiegów nie oddał pracy i wszystko robił sam, przerywany każdą nową wiadomością. Prompt zachęcający do delegowania zadziałał w czterech przebiegach na pięć. W piątym model uznał zadanie za „małe”, wykonał je sam i 95. percentyl czasu znów sięgnął 29 minut.
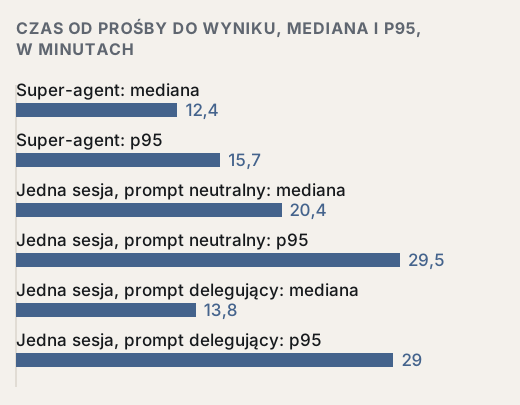
Wniosek: delegowanie, które zależy od oceny modelu w danej chwili, jest zawodne, więc pewniej wbudować je w architekturę. Kosztuje to tokeny: sesje Super-agenta odczytały z cache łącznie 23,2 mln tokenów na przebieg, wobec 6,1 mln i 10,8 mln w wariantach z jedną sesją.
Kod odsiewa, model ocenia
Wejściem Super-agenta są zdarzenia: wiadomości z grup, maile, przypomnienia z kalendarza, komentarze z przeglądu kodu, wyniki CI. Większość z nich to szum, więc pierwszym filtrem jest zwykły kod. Sprawdza źródło, grupę i listy dozwolonych osób oraz botów, a każde źródło ma jedno z trzech ustawień: odpowiadaj tylko na wyraźne prośby, oceniaj jako kandydatów albo ignoruj. Dopiero to, co przejdzie, ocenia model, według reguł spisanych zwykłym językiem, które zespół może zmienić w każdej chwili.
Kolejne zdarzenia z tego samego pull requesta albo wątku na czacie trafiają prosto do wykonawcy, który już prowadzi to zadanie, z pominięciem routera. Bez tego skrótu zadania kończyły się równie szybko, ale router podejmował o około 30% więcej decyzji, a tokenów odczytanych z cache było o około 37% więcej. Router wytrzymuje sporo, bo zdarzenia, które przyjdą w trakcie jednego kroku, model dostaje razem w następnym. W osobnym teście routera, z symulowanymi wykonawcami, tempo wzrosło z około 1 do około 40 zdarzeń wymagających decyzji na minutę, a uśredniony czas obliczeń na jedną decyzję spadł z 6,4 do 1,6 sekundy. Zanim podzielisz centralną sesję na kilka i stracisz wspólny kontekst, zmierz, czy naprawdę nie nadąża.
Kontekst podawany po kawałku
Autorzy traktują okno kontekstu jak pamięć podręczną. Model dostaje identyfikator i krótkie streszczenie zdarzenia, a do tego to, czego najpewniej zaraz użyje: identyfikatory powiązanych obiektów, sąsiednie wiadomości i tę, na którą ktoś odpowiada. Resztę zastępuje odnośnik, po który model sięga narzędziem, gdy jej potrzebuje. Każde zdarzenie, wątek i sesja wykonawcy ma identyfikator, więc router może przejść po odnośnikach do historii starego zadania, gdy ktoś wróci do niego na innym kanale. W oryginale te mechanizmy nazywają się Inline & Spill oraz Chain of Recall.
Prototyp podaje konkretne limity: przy ocenie kandydata na nowe zadanie model widzi pięć pierwszych wiadomości wątku i po pięć wokół zdarzenia, a długie wiadomości są skrócone, z podaną pełną długością. Zamiast wklejać modelowi cały wątek, lepiej dać mu streszczenie, identyfikatory i narzędzie do doczytania reszty.
Agent mówi mniej, niż robi
Długie polecenia nie blokują rozmowy. start() od razu zwraca „Started”, wynik przychodzi później jako nowe zdarzenie, a stop() przerywa to, co trwa za długo. DeepSeek Harness ma już ten mechanizm, choć domyślnie wyłączony. Agent może też pracować z wyprzedzeniem. W wewnętrznej grupie DeepSeek działa reguła „po cichu odtwórz i napraw”: gdy ktoś zgłasza problem, agent w tle próbuje go odtworzyć i znaleźć poprawkę, a odzywa się dopiero wtedy, gdy potwierdzi błąd i ma prostą poprawkę. W przeciwnym razie milczy.
Każdy kanał ma własny styl. Na czacie agent pisze tylko wtedy, gdy potrzebna jest decyzja albo akceptacja, krótko i z konkretnym pytaniem. U DeepSeek sprawdza się twardy limit 100 słów na odpowiedź. W pull requeście i mailu jest odwrotnie: pełny opis problemu, zmiany i weryfikacji. Prototyp zamyka zadanie na czacie jednym zdaniem z wynikiem, linkiem i ewentualnym następnym krokiem, a każdą wiadomość na GitHubie zaczyna od zdania, że napisał ją automatyczny agent.
Mózg w chmurze, ręce na Twoim komputerze
Lokalny agent zasypia razem z laptopem. Super-agent rozdziela trzy rzeczy: pętla agenta działa w bezstanowych kontenerach w chmurze, stan sesji leży w bazie danych, a repozytorium i narzędzia zostają na komputerze dewelopera, gdzie lekki demon tylko wykonuje polecenia. Lokalne zmiany bez commita, poświadczenia i dostęp do sieci wewnętrznej nie muszą więc trafiać do chmury, a zadania czekające na wyłączony laptop ruszają, gdy wróci do sieci. Podłączanie własnego komputera autorzy nazywają BYOM (Bring Your Own Machine). Anthropic opisał w kwietniu podobny podział dla swoich zarządzanych agentów.
Całości pilnuje Watchdog, osobna sesja uruchamiana według harmonogramu poza głównym systemem. Oprócz błędów API sprawdza, czy każdy wykonawca robi faktyczne postępy i nie odpłynął od celu, bo proces może działać, a model kręcić się w kółko.
Prototyp: bezpieczniki do skopiowania
dsh-superagent-prototype to napisana w TypeScripcie wtyczka do DeepSeek Harness, otwartego środowiska dla agentów na licencji MIT. Obsługuje jedno repozytorium na GitHubie i opcjonalnie czat Feishu, a jej zasada brzmi: zabierać jak najmniej ludzkiej uwagi i dawać jak najwięcej wartości. Najcenniejsze są bezpieczniki. Listy i uprawnienia egzekwuje kod, a reguły scalania i zrzutów ekranu to domyślne instrukcje w promptach zespołu:
- Agent ma własne konto na GitHubie, nigdy konto operatora, bo wszystko, co napisze, pojawi się pod tą nazwą.
- Domyślnie zlecać pracę może tylko osoba z listy, zwracając się wprost do agenta. Treść wiadomości i cytowane dokumenty są danymi do oceny i nie zmieniają uprawnień.
- Praca, której nikt nie zlecił, ma tryby
off,observeiauto. Domyślnyobservetylko zapisuje, że agent wziąłby zadanie. Naautoprzechodzi się po przejrzeniu tych zapisów. - Agent nie scala własnych pull requestów. Bez skonfigurowanego narzędzia do scalania robi to człowiek, a automatyczne scalanie wchodzi w grę tylko przy zmianie poniżej 200 linii, gdy wymagane zatwierdzenia obejmują ostatni commit.
- Zmiana interfejsu wymaga zrzutów ekranu przed i po, w tym samym scenariuszu. Sam zrzut po zmianie oznacza pracę niedokończoną.
- Ze środowiska poleceń znikają zmienne z
KEY,PASSWORD,SECRETlubTOKENw nazwie. Dokumentacja zaznacza jednak, że wykonawca nie jest odizolowany: działa jako użytkownik systemowy operatora z pełnym dostępem i może czytać jego katalog domowy, dlatego zaleca osobne konto systemowe z samymi poświadczeniami agenta.
Granice, które autorzy podają sami
Autorzy nazywają swoje wyniki orientacyjnymi. Test był syntetyczny, około 300 wiadomości na przebieg, w tym około 20 próśb o pracę, i mierzył koordynację, bo programowanie zastępowało narzędzie, które tylko zużywa czas. Tekst na X to maszynowe tłumaczenie z chińskiego. Opublikowany prototyp różni się od wewnętrznej wersji, nie zawiera części opisanych pomysłów, a według README w dużej części napisali go agenci programistyczni.
Dla firmy najważniejsza z otwartych kwestii to bezpieczeństwo. Chmurowa pętla przyjmuje zdarzenia z zewnątrz i ma dostęp do komputerów z prywatnym kodem i poświadczeniami. Udany atak typu prompt injection albo włamanie na serwer otwiera więc drogę do każdego podłączonego urządzenia, a poświadczenie, które trafi do kontekstu modelu, może wyciec nawet bez ataku. Agent musiałby korzystać z poświadczeń, nie widząc ich, i autorzy przyznają, że tego jeszcze nie rozwiązali. Otwarta pozostaje też pamięć długoterminowa po miesiącach pracy.
Od czego zacząć we własnym zespole
Przed podłączeniem agenta do czatu i repozytorium:
- Policz sesje. Jeśli ktoś w zespole prowadzi naraz więcej niż pięć sesji agenta, ograniczeniem jest uwaga i mocniejszy model tego nie zmieni.
- Zapisz w kodzie, które kanały agent czyta, czyje prośby przyjmuje i które boty ignoruje. Model ocenia tylko to, co przejdzie ten filtr.
- Oddziel przydzielanie od wykonywania. Sesja, która rozmawia z ludźmi, sama nie wykonuje pracy, a wykonawcy nie piszą do ludzi.
- Pracę, której nikt nie zlecił, zacznij w trybie obserwacji i przeczytaj, co agent by zrobił, zanim pozwolisz mu działać bez prośby.
- Załóż agentowi osobne konto na GitHubie, zablokuj scalanie jego własnych pull requestów i uruchamiaj jego polecenia na osobnym koncie systemowym, bez dostępu do Twoich sekretów.
- Monitoruj postęp zadań, a nie tylko to, czy proces działa.
Źródła
- 01DeepSeek Harness (Yujia Qiao), Exploring Super-agent Design: Towards a More Autonomous Agent System, article on Xopublikowano 1 listopada 2026
- 02GitHub, deepseek-ai/dsh-superagent-prototype, READMEpierwszy commit 31 października 2026
- 03dsh-superagent-prototype, docs/000‑philosophy.mdcommit z 31 października 2026
- 04dsh-superagent-prototype, docs/002‑authorization.mdcommit z 31 października 2026
- 05dsh-superagent-prototype, docs/006‑deployment.mdcommit z 31 października 2026
- 06dsh-superagent-prototype, prompts/admission.mdcommit z 31 października 2026
- 07dsh-superagent-prototype, prompts/team/communication.mdcommit z 31 października 2026
- 08dsh-superagent-prototype, prompts/team/delivery.mdcommit z 31 października 2026
- 09GitHub, deepseek-ai/deepseek-harnessrepozytorium utworzone 13 sierpnia 2026
- 10Anthropic, Scaling Managed Agents: Decoupling the brain from the handsopublikowano 8 kwietnia 2026