Modele fundamentalne uczą się liczb, nie tylko słów
Model fundamentalny uczy się raz, na ogromnej ilości danych, a potem obsługuje wiele różnych zadań bez trenowania od nowa. Tak działa ChatGPT na tekście. Od kilkunastu miesięcy ta sama recepta trafia na liczby: tabele, transakcje i szeregi czasowe, czyli dokładnie to, co Twoja firma zbiera w systemach od lat.
Przez ostatnią dekadę uczenie maszynowe w firmach wyglądało zawsze tak samo. Do każdego pytania budowało się osobny model: jeden do prognozy sprzedaży, drugi do oceny ryzyka, trzeci do rekomendacji. Każdy miał własne dane, własne przygotowanie cech i własne utrzymanie. Najwięcej czasu zajmowało nie samo uczenie, tylko żmudne układanie danych pod jedno konkretne pytanie.
Jeden model zamiast dziesięciu
Model fundamentalny odwraca tę kolejność. Najpierw powstaje jeden duży model, uczony na ogromnym zbiorze danych bez konkretnego zadania, a dopiero potem przykłada się go do kolejnych pytań. Z tekstem znamy to z ChatGPT. Nowość ostatnich kilkunastu miesięcy polega na tym, że ta sama recepta zaczęła działać na danych liczbowych, i to lepiej niż metody, które w tabelach rządziły od lat.
TabPFN: przewidywanie bez uczenia modelu
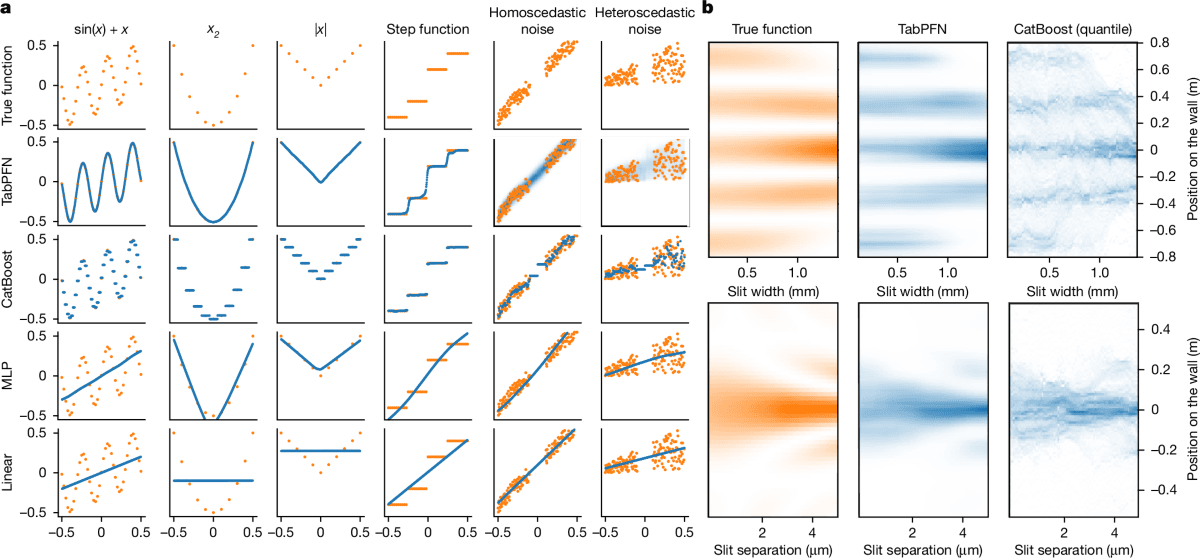
TabPFN pracuje na zwykłych tabelach: wiersze, kolumny i jedna kolumna do przewidzenia. Opisano go w „Nature” w styczniu 2025 roku, a rozwija go Prior Labs, firma założona przez autorów tej pracy. Najdziwniejsze jest to, że model w ogóle nie uczy się na Twoich danych. Został wytrenowany wcześniej, na około 130 milionach sztucznie wygenerowanych zbiorów. Twoją tabelę dostaje na wejściu i zwraca przewidywania w jednym przebiegu, bez strojenia.
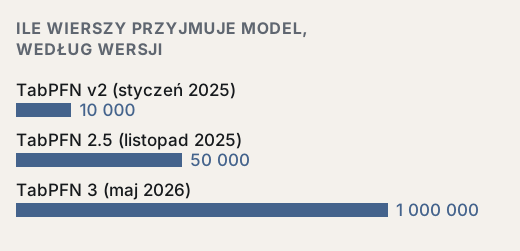
- Wersja opisana w „Nature” obsługuje zbiory do 10 000 wierszy i 500 kolumn.
- Według abstraktu tej pracy wypada lepiej niż drzewa wzmacniane gradientowo strojone przez cztery godziny, przy przyspieszeniu rzędu 5140 razy dla klasyfikacji.
- TabPFN 2.5 podniósł limit do 50 000 wierszy i 2000 kolumn i dorównuje dokładnością AutoGluonowi strojonemu przez cztery godziny.
- TabPFN 3 z maja 2026 przyjmuje już milion wierszy i 200 kolumn.
PRAGMA: 24 miliardy zdarzeń z jednego banku
Revolut poszedł w drugą stronę i wziął własną historię. PRAGMA to rodzina modeli od 10 milionów do miliarda parametrów, wytrenowana na 24 miliardach zdarzeń bankowych od 26 milionów użytkowników ze 111 krajów, co dało 207 miliardów tokenów z 25 miesięcy. Zdarzeniem jest tu nie tylko przelew, ale też wejście do aplikacji czy zmiana ustawień konta. Jeden wspólny model obsługuje zadania, które wcześniej wymagały osobnych systemów: scoring, fraud, rekomendacje i kilka innych.
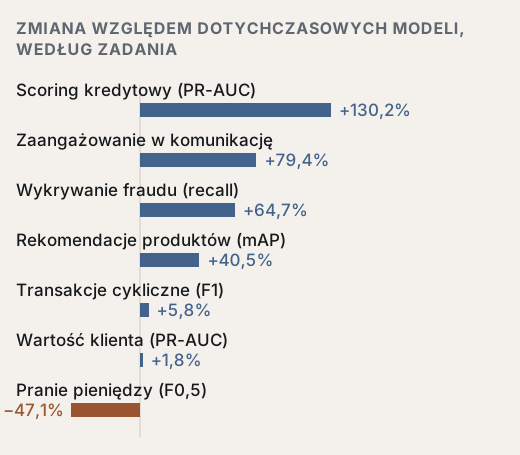
Wyniki są nierówne i właśnie dlatego warto na nie patrzeć. Scoring kredytowy poprawił się o 130,2 procent w mierze PR‑AUC. Wykrywanie fraudu łapie o 64,7 procent więcej przypadków, i to przy wyższej precyzji. Rekomendacje produktów zyskały 40,5 procent. Przy przewidywaniu wartości klienta różnica jest w granicach błędu, a przeciwdziałanie praniu pieniędzy wypadło o 47,1 procent gorzej niż dotychczasowe rozwiązanie.
W opisie wdrożenia pada też rzecz, która w praktyce znaczy więcej niż pojedyncza metryka: przygotowanie cech, czyli najdroższy etap klasycznego projektu, skróciło się z miesięcy niemal do zera, bo model dostaje surową historię zdarzeń zamiast ręcznie policzonych wskaźników. Najmniejszy model z tej rodziny wytrenowano w około dwa dni na szesnastu kartach.
Synthefy: modele dla szeregów czasowych
Trzeci przykład jest znacznie wcześniejszy na osi czasu. Synthefy zebrało w sierpniu 2026 roku 6,5 miliona dolarów na modele fundamentalne dla danych ustrukturyzowanych: tabel, sygnałów i szeregów czasowych. Firma zapowiada między innymi generowanie syntetycznych szeregów czasowych z opisu tekstowego, żeby dało się testować rozwiązania bez ruszania prawdziwych danych klientów. To na razie zapowiedź i pieniądze, a nie recenzowane wyniki, więc traktuj to jako sygnał kierunku, a nie gotowe narzędzie.
Co to znaczy dla firmy bez zespołu AI
- Twoje dane już mają właściwy kształt. Tabela z zamówieniami albo historia transakcji to dokładnie ten materiał, na którym te modele pracują.
- Mały zbiór przestał być przeszkodą. W tabelach do kilkudziesięciu tysięcy wierszy nowe modele wygrywają z metodami, które wymagały tygodni strojenia.
- Najdroższy etap tanieje. Skoro model przyjmuje surową historię, mniej czasu idzie na ręczne przygotowanie cech.
- Porządek w danych nadal decyduje. Żaden model fundamentalny nie naprawi niespójnych identyfikatorów ani brakujących dat.
Czego te wyniki nie obiecują
Wynik z pracy naukowej to wynik na danych jej autorów. Revolut miał 24 miliardy zdarzeń, Ty prawdopodobnie nie masz, a i tak jedno z siedmiu zadań wyszło u nich gorzej. TabPFN świetnie radzi sobie z małą tabelą i nie zastąpi systemu rekomendacji działającego na milionach zdarzeń. Jedyny wiarygodny test to Twoje dane i miara sukcesu ustalona, zanim cokolwiek uruchomimy.
Jeśli chcesz sprawdzić, czy któreś z tych podejść ma sens przy Twoim procesie, napisz do nas. Zwykle wystarczy jedna tabela i jedno pytanie, na które ma odpowiadać.
Źródła
- 01Hollmann et al., Accurate predictions on small data with a tabular foundation model, Nature 637 (2025)
- 02Prior Labs, TabPFN‑2.5 model report
- 03Prior Labs, TabPFN‑3 technical report
- 04Ostroukhov et al., PRAGMA: Revolut Foundation Model, arXiv 2604.08649
- 05NVIDIA, Revolut case study
- 06Synthefy, seed round announcement, August 2026