Jev: model, który zwraca decyzję zamiast zdania
Większość pracy, którą firmy zlecają dziś modelom językowym, to nie pisanie. To decyzje: do którego działu trafia ta wiadomość, czy ta faktura wymaga akceptacji, jak pilne jest to zgłoszenie. Model językowy odpowiada na to zdaniem, które trzeba dopiero rozebrać na części. Jev odpowiada wartością, którą program odczytuje wprost.
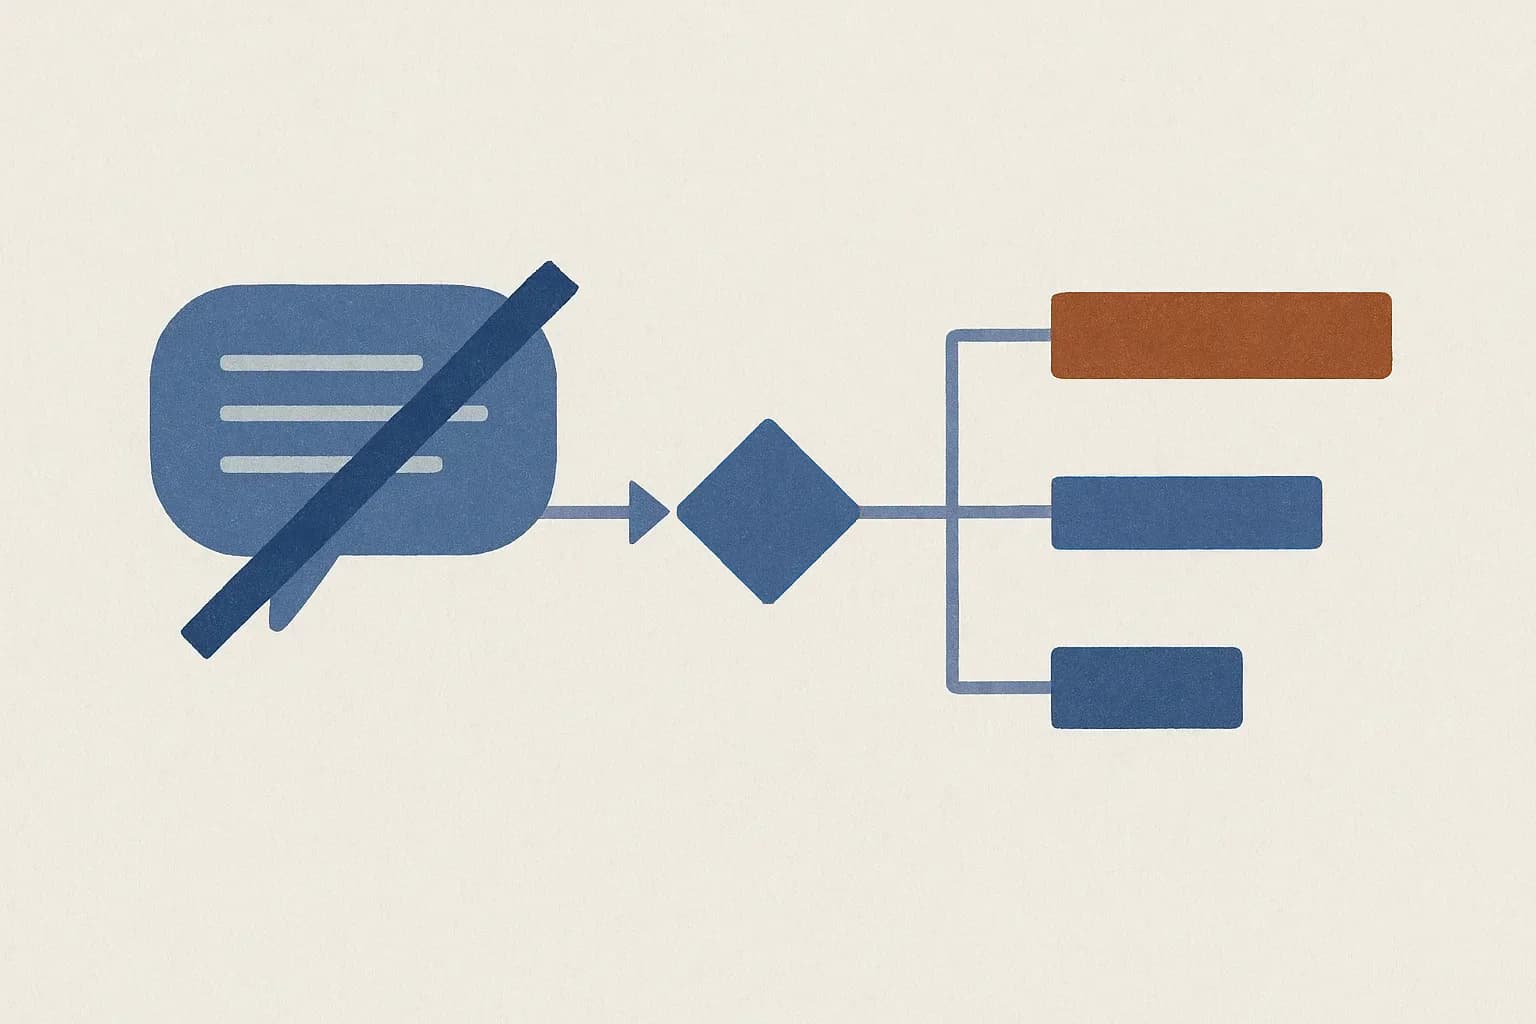
Do skrzynki firmowej wpada wiadomość. Trzeba ją przypisać do jednego z sześciu działów. Jeśli robi to dziś model językowy, dzieje się mniej więcej tak: wysyłasz treść razem z instrukcją, model pisze zdanie, twój kod wyciąga z tego zdania nazwę działu, a potem sprawdza, czy to na pewno jedna z sześciu dozwolonych nazw, bo czasem nie jest. Płacisz za każde słowo tej odpowiedzi i czekasz, aż model wypisze je po kolei.
Cała ta droga istnieje po to, żeby dostać jedną z sześciu wartości. 15 września 2026 roku firma TypeSafe AI udostępniła w ograniczonym dostępie model zbudowany wprost pod ten przypadek. Nazywa się Jev i nie generuje tekstu w ogóle. Zwraca wybraną opcję razem z prawdopodobieństwem dla każdej z pozostałych.
Firma powstała w 2024 roku w San Francisco, założyli ją Diogo Almeida, Erik Gafni i Sasha Sheng. Almeida spędził wcześniej około czterech lat w OpenAI przy RLHF, InstructGPT, ChatGPT i GPT‑4. Premierze towarzyszyła runda zalążkowa 40 milionów dolarów prowadzona przez DCVC. Almeida tłumaczy odejście jednym zdaniem: mamy błyskawicę w butelce, a nie potrafimy jej użyć, bo była optymalizowana pod ludzki język, a nie pod automatyzację.
Trzy kształty pytania
Jev przyjmuje pytanie w jednym z trzech kształtów i to jest cały jego interfejs. Nie ma tu miejsca na dowolną instrukcję, bo nie ma też dowolnej odpowiedzi.
- Wybór z listy. Podajesz zamknięty zbiór opcji, dostajesz jedną z nich i prawdopodobieństwo dla każdej. Maksymalnie 255 opcji.
- Ocena na skali. Podajesz uporządkowane poziomy, na przykład od „bardzo pilne” do „może poczekać”, dostajesz poziom i rozkład prawdopodobieństwa.
- Ocena zdania. Podajesz twierdzenie, dostajesz liczbę od 0 do 1, czyli na ile model uważa je za prawdziwe.
Różnica wobec modelu językowego nie kończy się na formacie odpowiedzi. Model językowy pisze token po tokenie, więc czas odpowiedzi rośnie z jej długością. Jev liczy wszystkie wyjścia równolegle w jednym zapytaniu, bo nie ma czego dopisywać. Trenowany jest metodą, którą firma nazywa RLCD, gdzie prawdopodobieństwa są dostrajane do faktycznych wyników, a nie do ocen ludzkich recenzentów. Producent podaje też, że dane treningowe są w całości syntetyczne.
Prawdopodobieństwo nie jest tu ozdobnikiem. Jeśli jest skalibrowane, to znaczy, że wynik 0,9 naprawdę oznacza dziewięć trafień na dziesięć, i można na nim postawić próg: powyżej system działa sam, poniżej sprawa idzie do człowieka albo do droższego modelu. Tego z gołego zdania od modelu językowego nie da się zrobić.
Liczby, które podaje producent
Wszystkie poniższe pochodzą z ogłoszenia TypeSafe AI, czyli od firmy, która ten model sprzedaje. Warto je czytać z tą świadomością, bo sama firma opisuje je jako górną granicę tego, co widać w praktyce.
- Czas odpowiedzi od 70 do 500 milisekund, wobec od 3 do 329 sekund dla czołowych modeli językowych na tych samych zadaniach.
- Od 40 do 200 razy szybciej przy porównywalnej jakości decyzji. W jednym z wewnętrznych przepływów 193,6 razy szybciej i 444,6 razy taniej.
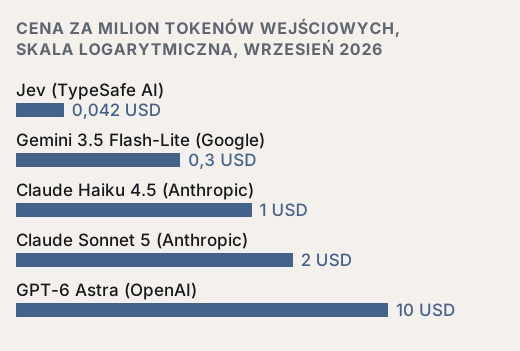
- 0,042 dolara za milion tokenów wejściowych, czyli 42 dolary za miliard. Tokeny wyjściowe są darmowe, bo jest ich tyle, że firma nie widzi sensu ich liczyć.
- Zero błędów formatu, gwarantowane budową modelu, a nie zmierzone. Odpowiedź może być tylko jedną z wartości, które sam podałeś.
Liczby spoza firmy
To ta część, która decyduje. TechCrunch opisał dwa wdrożenia u zewnętrznych zespołów. Vercel użył Jeva jako klasyfikatora bezpieczeństwa i podaje wynik od 5 do 18 razy szybszy niż na modelu Luna 5.6 od OpenAI, przy wyższej trafności. Bryo AI klasyfikuje nim pocztę i podaje koszt od 10 do 20 razy niższy niż na Gemini, z dodatkową korzyścią w postaci skalibrowanej pewności.
To nadal liczby podane przez zadowolonych użytkowników, nie przez niezależny pomiar, ale rząd wielkości jest niższy niż w materiałach producenta i to akurat jest dobry znak. Armin Ronacher, CTO Earendel, dodaje do tego jedno zastrzeżenie: wartość takiego modelu zależy od tego, czy potrafisz sensownie zinterpretować zwracaną pewność. Sama liczba niczego nie załatwia, jeśli nikt nie ustalił, co się dzieje poniżej progu.
Czego Jev nie zrobi
- Nie napisze zdania, streszczenia ani kodu. Rezygnacja z generowania tekstu jest tu świadoma i nieodwracalna.
- Nie obsłuży więcej niż 255 opcji, więc nie przypisze zgłoszenia do jednej z tysiąca kategorii produktowych.
- Nie zastąpi modelu językowego tam, gdzie odpowiedź czyta człowiek.
- Nie ma opublikowanej pracy naukowej ani wag. Architektura i sposób treningu pozostają opisem firmy o sobie samej.
- Jest w ograniczonym wczesnym dostępie, więc planowanie wdrożenia produkcyjnego na wrzesień 2026 to planowanie na liście oczekujących.
Gdzie to ma sens w mniejszej firmie
Wszędzie tam, gdzie decyzja jest prosta, powtarza się tysiące razy dziennie i dziś albo kosztuje za dużo, albo robi ją człowiek.
- Kierowanie poczty i zgłoszeń do właściwego zespołu, z progiem pewności, poniżej którego trafiają do skrzynki ogólnej.
- Wstępna segregacja dokumentów przed droższym modelem, który czyta tylko to, co naprawdę wymaga czytania.
- Ocena pilności i priorytetu w kolejce serwisowej, gdzie liczy się czas odpowiedzi, a nie elokwencja.
- Nadzór nad istniejącym wdrożeniem AI: sprawdzanie każdej odpowiedzi modelu językowego kosztuje dziś tyle, że nikt tego nie robi na wszystkich.
Zanim oprzesz na tym proces, sprawdź cztery rzeczy
- 01Czy Twoja decyzja naprawdę mieści się w zamkniętej liście do 255 pozycji, a jeśli nie, to czy da się ją rozbić na dwa pytania.
- 02Ile decyzji dziennie podejmujesz w tym miejscu. Poniżej kilku tysięcy różnica w cenie nie zwróci kosztu zmiany.
- 03Co się dzieje z przypadkiem poniżej progu pewności. Jeśli odpowiedź brzmi „nic”, próg nie działa.
- 04Czy masz zapisane wcześniejsze decyzje w tej sprawie. Bez nich nie zmierzysz, czy model jest lepszy od tego, co już robicie.